br/>基础篇 RAG、AI工作流与AI Agent核心概念
第1章 理解RAG:外部知识的检索与融合3
1.1 概念缘起与应用价值3
1.1.1 RAG的基本概念3
1.1.2 大模型的内在局限4
1.1.3 RAG的核心应用价值5
1.1.4 RAG的主要应用场景6
1.2 核心工作原理解析7
1.2.1 文档解析与加载8
1.2.2 文本分块策略9
1.2.3 向量化与索引构建12
1.2.4 检索器设计与优化14
1.2.5 生成器配置与多轮对话增强15
1.3 技术生态与实践路径18
1.3.1 技术栈分层全景18
1.3.2 框架与平台选型策略19
1.3.3 RAG应用范式演进20
1.4 本章小结21
第2章 构建AI工作流:复杂任务的编排与自动化22
2.1 概念缘起与应用价值22
2.1.1 AI工作流的基本概念23
2.1.2 单点AI应用的内在局限24
2.1.3 AI工作流的核心应用价值25
2.1.4 AI工作流的主要应用场景26
2.2 核心工作原理解析27
2.2.1 节点类型与连接机制28
2.2.2 条件分支与循环控制30
2.2.3 状态管理与数据传递机制32
2.2.4 并行执行与同步机制33
2.2.5 错误处理与容错机制34
2.3 技术生态与实践路径36
2.3.1 AI工作流技术栈分层全景36
2.3.2 框架与平台选型策略38
2.3.3 AI工作流应用范式演进39
2.4 本章小结41
第3章 探索AI Agent:自主决策能力的构建与应用42
3.1 概念缘起与应用价值42
3.1.1 AI Agent的基本概念43
3.1.2 AI工作流的内在局限44
3.1.3 AI Agent的核心应用价值45
3.1.4 AI Agent的主要应用场景46
3.2 核心工作原理解析47
3.2.1 推理引擎与策略制定48
3.2.2 记忆系统与上下文管理50
3.2.3 工具调用与管理54
3.2.4 感知反馈与迭代55
3.3 技术生态与实践路径57
3.3.1 技术栈分层全景58
3.3.2 框架与平台选型策略59
3.3.3 AI Agent应用范式演进60
3.4 本章小结61
RAG篇 构建从基础到高级的问答应用
第4章 开发企业规章制度原生RAG问答系统65
4.1 业务挑战65
4.1.1 分散存储的文档查找难题66
4.1.2 关键词检索的语义鸿沟66
4.1.3 碎片信息的整合困境66
4.2 核心架构67
4.2.1 构建统一文档解析流水线67
4.2.2 建立向量化语义检索引擎68
4.2.3 设计检索增强问答生成器68
4.3 技术实现69
4.3.1 分析全局配置与参数管理70
4.3.2 实现文档解析与结构化分块72
4.3.3 构建向量化与索引存储系统73
4.3.4 开发检索与生成核心引擎75
4.3.5 部署交互界面与实战验证77
4.4 工程经验与架构演进80
4.4.1 原生开发的工程经验总结80
4.4.2 系统性能瓶颈分析与优化方向81
4.4.3 向框架化开发的演进路径82
4.5 本章小结82
第5章 打造框架驱动的智能简历筛选系统84
5.1 业务挑战84
5.1.1 异构文件的统一接入难题85
5.1.2 精准筛选与模糊检索的平衡难题85
5.1.3 从信息检索到决策辅助的鸿沟85
5.2 核心架构86
5.2.1 构建统一的数据处理流水线87
5.2.2 设计双层知识存储引擎87
5.2.3 编排对话式RAG应用链88
5.3 技术实现88
5.3.1 实现基于LlamaIndex的数据处理引擎89
5.3.2 开发上下文感知的简历节点解析器90
5.3.3 构建并集成结构化信息92
5.3.4 开发基于Pydantic的结构化信息提取链93
5.3.5 集成记忆功能的对话式RAG链94
5.3.6 部署基于Streamlit的交互式验证应用96
5.4 工程经验与架构演进101
5.4.1 框架开发的权衡与选型101
5.4.2 “引擎―应用”分离的设计模式101
5.4.3 架构演进:从问答到自主Agent102
5.5 本章小结102
第6章 实现基于RAGFlow的设备维修图文问答103
6.1 业务挑战103
6.1.1 维修案例检索效率问题104
6.1.2 图文信息割裂展示难题104
6.1.3 跨案例知识整合能力缺失104
6.2 核心架构104
6.2.1 解析RAGFlow的原生快照架构105
6.2.2 设计基于预处理的富文本增强架构106
6.2.3 两种架构的技术选型与权衡107
6.3 技术实现109
6.3.1 配置解析器与分块策略109
6.3.2 设置检索增强功能111
6.3.3 配置结构化信息提取112
6.3.4 调整聊天助手核心策略配置114
6.3.5 评测原生PDF的解析与检索效果116
6.3.6 开发PDF图文提取与链接注入脚本119
6.4 工程经验与架构演进123
6.4.1 提炼平台与预处理的协同范式124
6.4.2 从信息检索到任务自动化的架构演进124
6.4.3 展望RAGFlow的Agent与MCP应用潜力125
6.5 本章小结125
第7章 复现企业级RAG挑战赛冠军方案126
7.1 业务挑战126
7.1.1 海量异构的动态数据127
7.1.2 严格的评分与奖惩机制127
7.1.3 跨文档对比与深度推理要求128
7.1.4 时间与成本的双重挤压129
7.2 核心架构129
7.2.1 数据预处理流水线131
7.2.2 两阶段检索策略131
7.2.3 多路由生成框架132
7.3 技术实现133
7.3.1 Docling二次开发与GPU配置133
7.3.2 一文一库构建、查询路由与大模型精排135
7.3.3 多路由设计与自愈修正代码137
7.3.4 结构化提示词工程139
7.3.5 复现实录梳理140
7.3.6 可视化交互界面142
7.4 工程经验与架构演进144
7.4.1 构建可复现的实验评估体系145
7.4.2 从“银弹”思维到全链路系统工程思想146
7.4.3 迈向更智能的动态与交互式系统146
7.5 本章小结147
AI工作流篇 任务流程的编排与自动化
第8章 构建智能合同审查工作流151
8.1 业务挑战151
8.1.1 异构知识的融合困境151
8.1.2 坏案例的沉淀难题152
8.1.3 审查任务的拆解瓶颈152
8.2 核心架构153
8.2.1 构建双源输入架构153
8.2.2 定义结构化案例知识库153
8.2.3 编排四阶段工作流154
8.3 技术实现156
8.3.1 搭建结构化案例知识库156
8.3.2 配置工作流输入变量158
8.3.3 实现动态案例检索159
8.3.4 自动化整合与报告生成161
8.3.5 实战演练与验证163
8.4 工程经验与架构演进167
8.4.1 核心工程原则167
8.4.2 数据优先模型168
8.4.3 架构演进方向168
8.5 本章小结168
第9章 构建智能合同生成工作流169
9.1 业务挑战169
9.1.1 静态模板的刚性局限169
9.1.2 仿写生成的串扰风险170
9.1.3 全文处理的低效瓶颈171
9.2 核心架构171
9.2.1 构建条款级知识库172
9.2.2 设计并行生成流程172
9.2.3 实现自动化交付173
9.3 技术实现173
9.3.1 实现数据离线预处理174
9.3.2 搭建并行工作流177
9.3.3 配置RAG核心组件179
9.3.4 实现自动化合并交付182
9.3.5 实战演练与效果验证185
9.4 工程经验与架构演进189
9.4.1 可复用的核心工程经验189
9.4.2 架构演进:动态循环架构190
9.5 本章小结191
第10章 构建Text2SQL智能数据分析工作流192
10.1 业务挑战192
10.1.1 从业务逻辑到SQL的转换鸿沟193
10.1.2 数据孤岛的权限与性能瓶颈193
10.1.3 手动编码的成本与安全困境193
10.2 核心架构194
10.2.1 构建三大核心知识库194
10.2.2 分离数据取数与分析计算195
10.2.3 构建自愈式安全校验闭环195
10.3 技术实现196
10.3.1 准备案例数据源197
10.3.2 创建三大核心知识库198
10.3.3 构建SQL生成引擎201
10.3.4 搭建自愈式安全校验网关204
10.3.5 实现完整的取数与分析206
10.3.6 LLM总结回答208
10.3.7 效果测试与能力验证208
10.4 工程经验与架构演进212
10.4.1 常见工程挑战与应对212
10.4.2 架构演进的三个方向213
10.5 本章小结213
第11章 构建异构银行流水动态解析工作流215
11.1 业务挑战215
11.1.1 定位流水表单的核心数据区域216
11.1.2 统一异构流水的核心字段216
11.1.3 定性交易摘要的真实性质217
11.2 核心架构218
11.2.1 设计“先预览后认知”的动态解析器218
11.2.2 构建“先指令后执行”的标准化数据流219
11.2.3 引入“知识增强”的智能分析与报告生成220
11.3 技术实现221
11.3.1 配置动态解析与合并节点221
11.3.2 构建“代码+知识库”的混合分析模式224
11.3.3 配置填充报告模板226
11.3.4 案例演示:生成一份完整的流水分析报告228
11.4 工程经验与架构演进231
11.4.1 大模型与代码节点协作模式232
11.4.2 动态RAG的优势232
11.4.3 融合多模态处理与知识图谱232
11.4.4 构建自修正反馈与人机协同的闭环系统232
11.5 本章小结233
AI Agent篇 构建企业级AI Agent系统
第12章 构建预测性设备运维Agent237
12.1 业务挑战237
12.1.1 跨越多业务系统的数据壁垒237
12.1.2 破解领域专家的“经验困局”238
12.1.3 突破“事后诊断”的决策模式瓶颈239
12.2 核心架构239
12.2.1 构建标准化的外部API工具集240
12.2.2 建立理论+经验的复合知识库240
12.2.3 设计融合知识与工具的动态决策Agent241
12.3 技术实现241
12.3.1 构建并处理复合知识库242
12.3.2 封装外部API为Dify工具244
12.3.3 配置Agent核心指令246
12.3.4 演示Agent真实场景对话行为250
12.4 工程经验与架构演进252
12.4.1 辨析Agent与工作流的适用场景与边界253
12.4.2 实现从“被动应答”到“主动预警”的模式升级253
12.4.3 驱动架构从“预警”向“自主行动与闭环”演进254
12.5 本章小结255
第13章 落地基于JoyAgent的智能信贷尽调助手256
13.1 业务挑战256
13.1.1 信贷尽调中多源数据整合的复杂性256
13.1.2 过于依赖专业分析经验与质量风险257
13.1.3 智能化转型的技术路径选择困境257
13.2 核心架构258
13.2.1 解析JoyAgent四层技术架构259
13.2.2 设计最小化侵入式的工具扩展机制259
13.2.3 构建信贷专用工具与外部服务集成260
13.3 技术实现261
13.3.1 搭建JoyAgent多服务开发环境262
13.3.2 准备信贷尽调演示数据263
13.3.3 开发Python数据服务脚本265
13.3.4 实现Java工具类与BaseTool接口的集成267
13.3.5 注册集成工具与系统配置270
13.3.6 端到端实战验证与效果展示272
13.4 工程经验与架构演进277
13.4.1 提炼最小化侵入的方法论277
13.4.2 解决多服务架构的运维复杂性278
13.4.3 系统演进的优化方向279
13.5 本章小结280
后记281
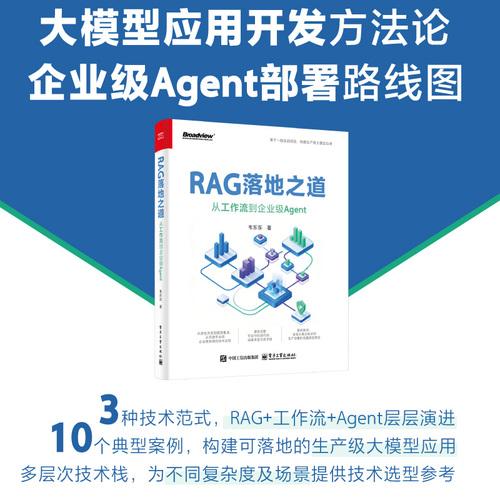
内容摘要
本书系统阐述了大模型应用从基础概念到企业级部署的完整技术路径。全书分为四部分:基础篇(第1~3章)深入解析RAG、AI工作流与AI Agent三大核心技术的原理、架构与生态;RAG篇(第4~7章)通过企业规章制度问答、智能简历筛选、设备维修图文问答、企业级竞赛方案复现等案例,展示从原生开发到框架集成再到平台应用的完整实现路径;AI工作流篇(第8~11章)涵盖智能合同审查与生成、Txt2SQL数据分析、异构银行流水解析等复杂业务场景的自动化处理方案;AI Agent篇(第12~13章)通过预测性设备运维和智能信贷尽调助手,展示自主决策智能体的构建与应用。每个案例均遵循‘业务挑战→核心架构→技术实现→工程经验与架构演进‘的统一结构,提供完整可运行的源代码,涵盖从原生Python库到企业级框架的多层次技术栈实现。本书既适合AI产品经理、AI项目经理、后端工程师、高校学生与研究人员阅读,也可作为企业大模型应用开发的实践指南。
 占位居中





 直播中,去观看
